读过的东西,大多没有变成笔记。偶尔做了笔记,也常常只是原文的缩写版:顺序一样,篇幅略短,划了几道线,一周后翻开,和重读原文差不多费劲。
一页好的手写笔记不是这样的。它有一个说清楚“这讲的是什么”的标题,左边一列可以用来自测的线索词,正文分成几段,只有少数几处被荧光笔标出来,最下面一句话总结。这页纸的价值不在抄下了多少,而在重构:哪些是主干,哪些是枝叶,哪些值得下次再想一遍。
墨语笔记(https://scribe.orangely.xyz/)想做的就是这件事:把粘贴进来的文章、会议记录、读书摘抄或零散想法,整理成一页具有手写质感、主次分明的笔记,再导出成图片或分享链接。
从一段文字到一页纸
点“撰写”,在弹窗里粘贴原文(最多一万二千字),选一个模板:通用整理、读书摘抄、会议纪要、课程总结、思想碎片。输出语言可以跟随原文,也可以指定中文或英文;详略分精简、标准、详细三档。按“转化为手写笔记”(或 Ctrl / ⌘ + Enter),弹窗收起,画布占满主区域。
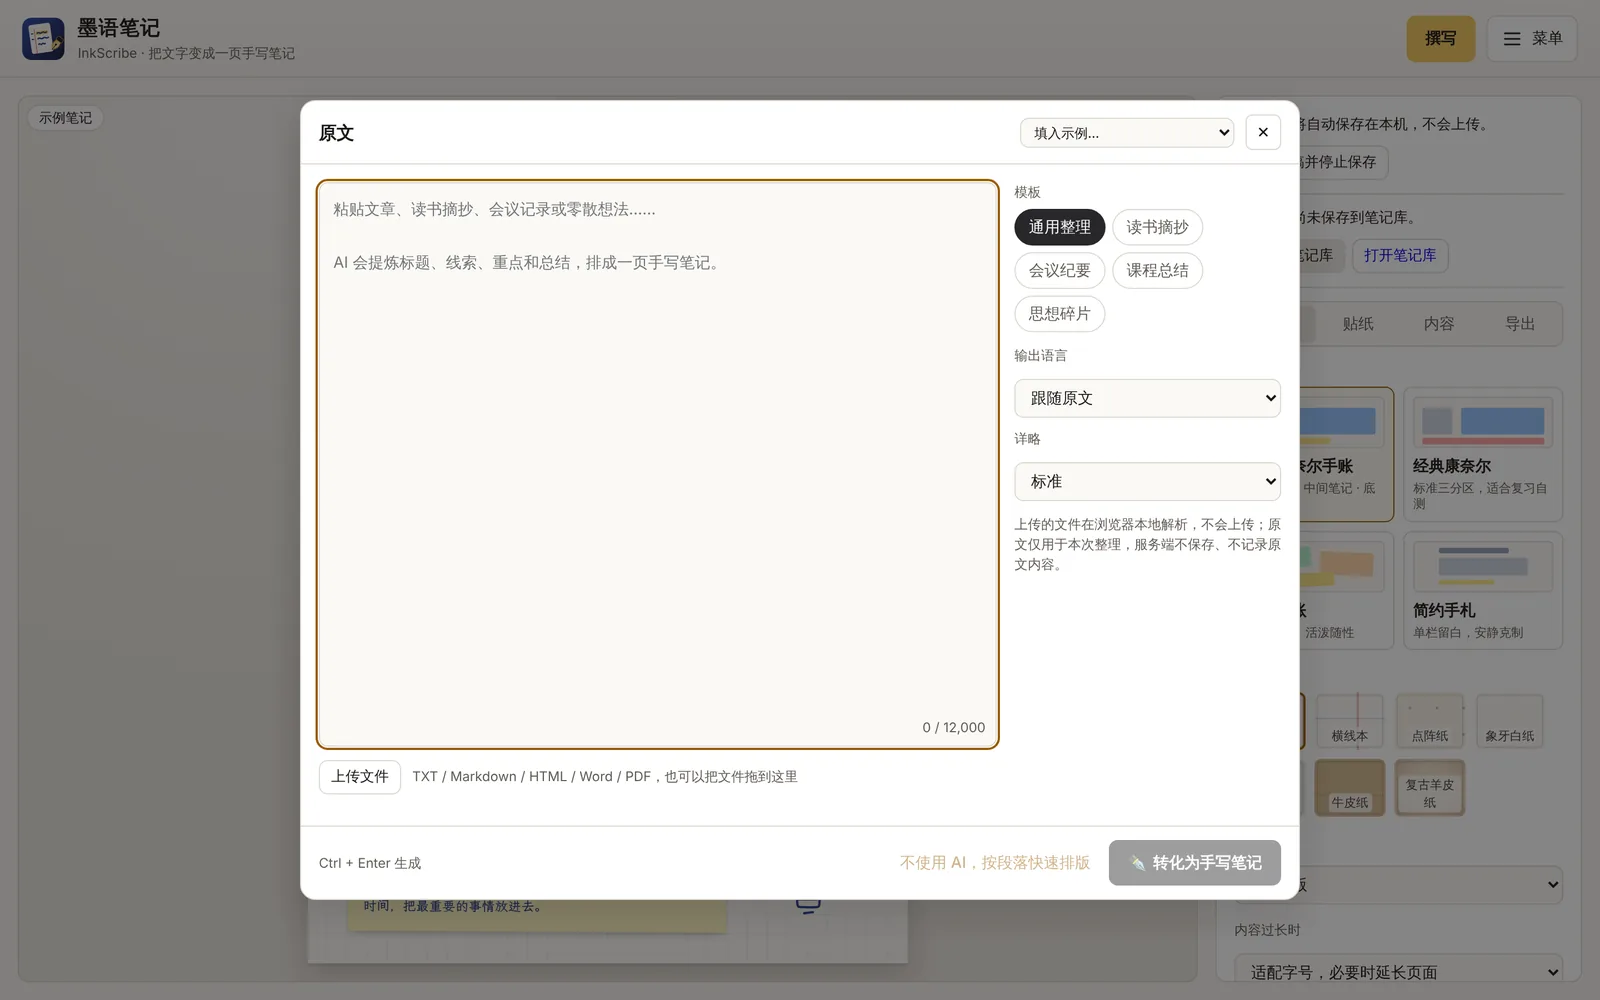
不必只靠粘贴。TXT、Markdown、HTML、Word(.docx)和文字型 PDF 都可以上传,或者直接拖到编辑页任意位置;文本编码会自动识别 UTF-8、UTF-16 和 GBK。文件在浏览器本地解析,只有提取出来的文字会用于整理。不想用 AI 的时候,还有一个“不使用 AI,按段落快速排版”的兜底,按段落和关键词抽取,即时出结果。
AI 整理后得到的不是一段自由发挥的文字,而是一份固定结构:标题、线索(关键词加一句说明)、分段正文、每段的重点词、总结,以及一个插图主题。这份结构在“内容”面板里可以逐项修改。
结构比字体重要
第一眼吸引人的是手写字体,但真正让这页纸有用的是结构。做的时候有几条规则我比较在意。
重点词必须逐字出现在正文里。 模型很容易“概括”出一个原文里没有的词,再把它当成重点;改了段落以后,原来的重点也可能已经不存在。墨语笔记只画那些在正文中真实出现的重点词,荧光笔永远落在纸面上真实的字上。
线索放在左边,是为了遮住右边。 康奈尔笔记的线索栏本来就是自测用的:盖住正文,只看线索,试着把内容讲出来。所以线索被要求写成“关键词 + 一句说明”,而不是正文标题的重复。
一页,而不是一份文档。 页面有 A4、3:4、1:1 和随内容延长的长图几种尺寸。“一页”的限制本身就是一种逼迫:放不下的东西,多半本来就不该放。
让它像你的本子
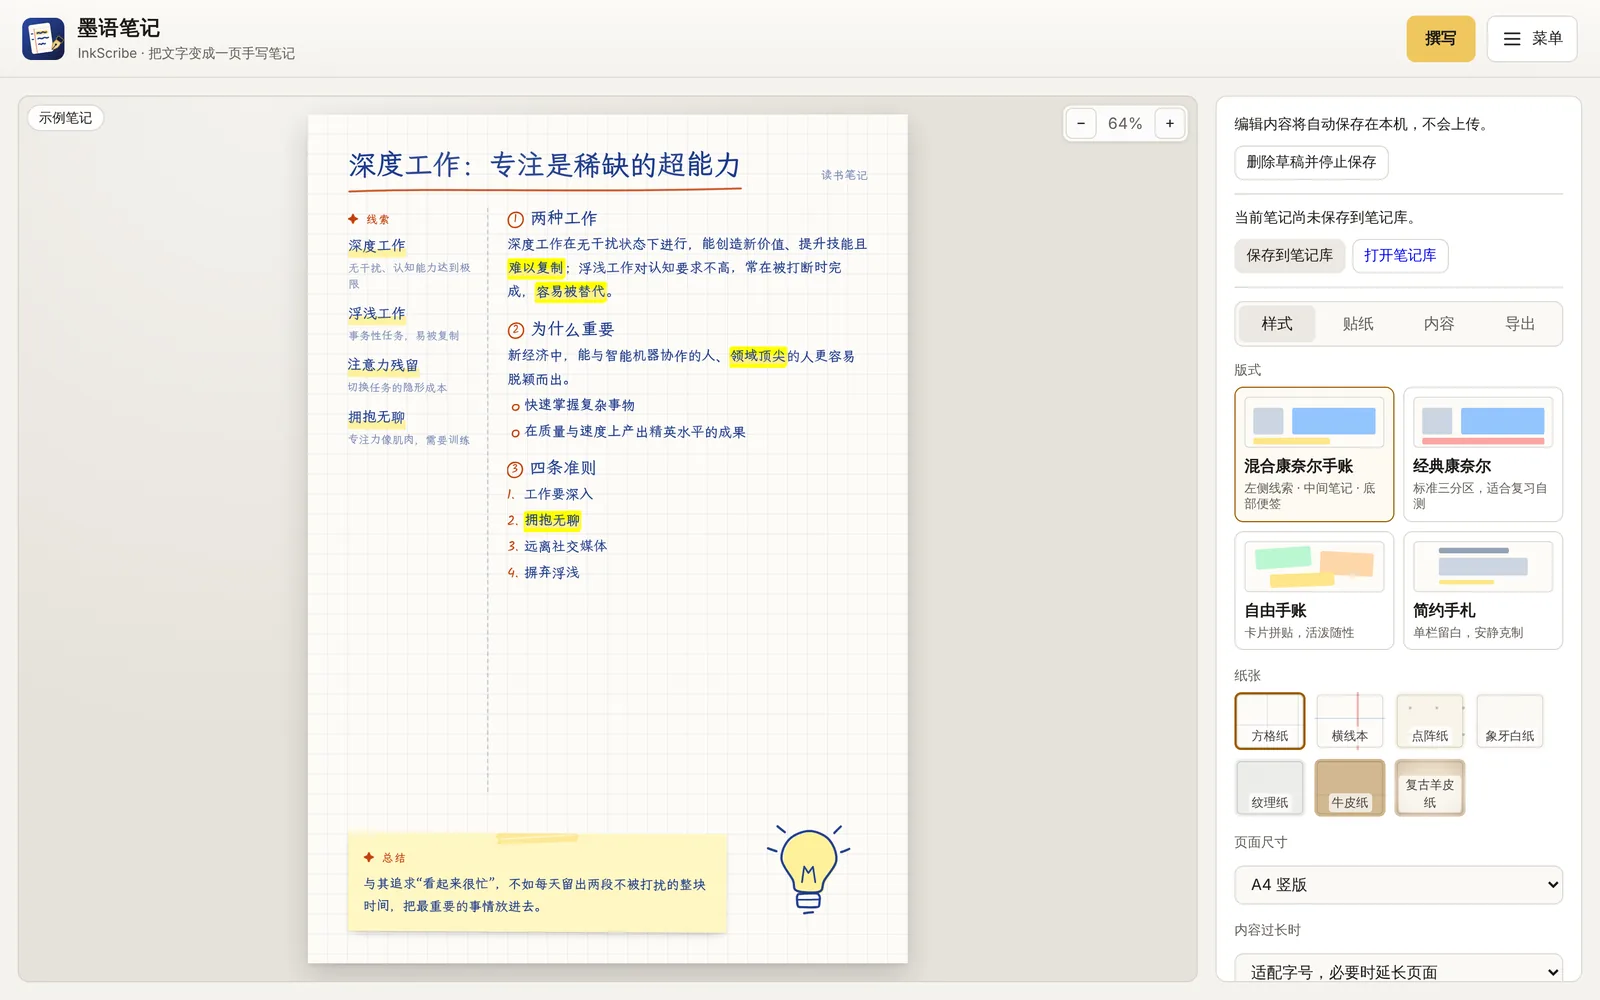
“样式”面板里能调的东西不少,大致分几组:
- 版式:混合康奈尔手账(左侧线索、中间笔记、底部便签总结)、经典康奈尔、自由手账(卡片拼贴)、简约手札。
- 纸张:方格纸、横线本、点阵纸、象牙白纸、纹理纸、牛皮纸、复古羊皮纸。
- 字体与墨水:五款中文手写字体(霞鹜文楷、龙藏体、马善政楷书、站酷快乐体、志莽行书)和四款英文手写字体,都是 OFL 授权;墨水有碳素黑、钢笔蓝、复古棕、黛绿、波尔多红,荧光笔三色。
- 自然手写感:逐字的基线浮动、墨色深浅、段落的微小倾斜,幅度可调。它用固定的随机种子生成,所以预览和导出的图片完全一致;不满意就点“换一种笔迹”。
“贴纸”面板里有和纸胶带、便利贴、回形针、星星、咖啡渍,以及二十个内置手绘插图,可以拖拽、缩放、旋转、调整层级,也能用键盘微调。插图由一个受控的生成器用少数几种图元(线、箭头、圆、矩形、折线)绘制,即使开启 AI 插图,模型也只能给出这些图元的规格,不能塞进任意 SVG。
内容放不下的时候
把任意长度的文字塞进固定尺寸的页面,最省事的做法是把放不下的部分裁掉。墨语笔记不这样做。它等字体真正加载完,再按实际渲染的尺寸测量:默认先在可读范围内缩小字号和行距,还放不下就展开成长图,正文、线索和总结一字不少;如果你坚持固定尺寸,它会提示溢出并禁止导出,而不是给你一张“导出成功”、却少了最后一段的图片。
导出支持 PNG、JPG 和一倍到三倍分辨率,也可以直接复制到剪贴板。中文字体按 unicode-range 分片、按需内嵌,一页笔记不会因此背上整套字库。
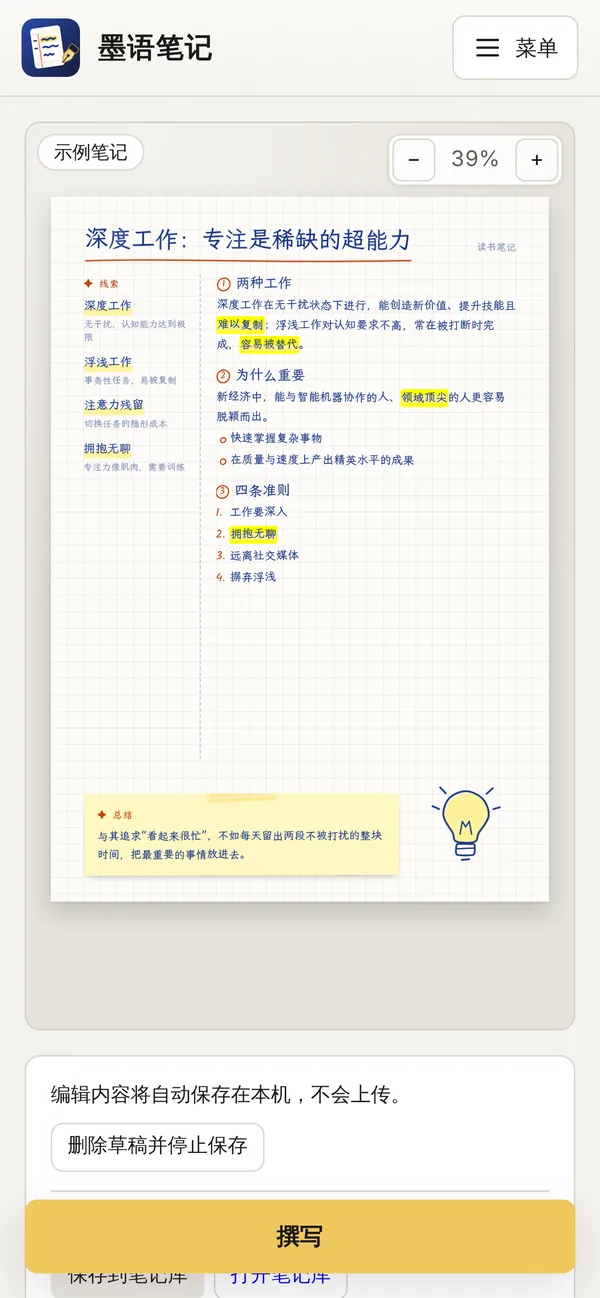
编辑中的草稿自动保存在本机的 IndexedDB 里,刷新后恢复;同一份草稿在两个标签页里打开时,会暂停保存而不是互相覆盖。值得留下的笔记可以“保存到笔记库”,笔记库同样只在本机,支持搜索、继续编辑和 JSON 备份导入导出。手机上,“撰写”按钮固定在屏幕底部,输入框以底部抽屉展开。
使用体验:让 agent 把本站的一篇文章做成笔记
越来越多的阅读和总结,其实已经发生在 AI 助手的对话里。所以墨语笔记还有一条不经过网页的路:任何 agent 都可以不注册、不申请密钥,直接调用发布接口,把已经整理好的笔记结构交给它排版,拿回一个查看链接。
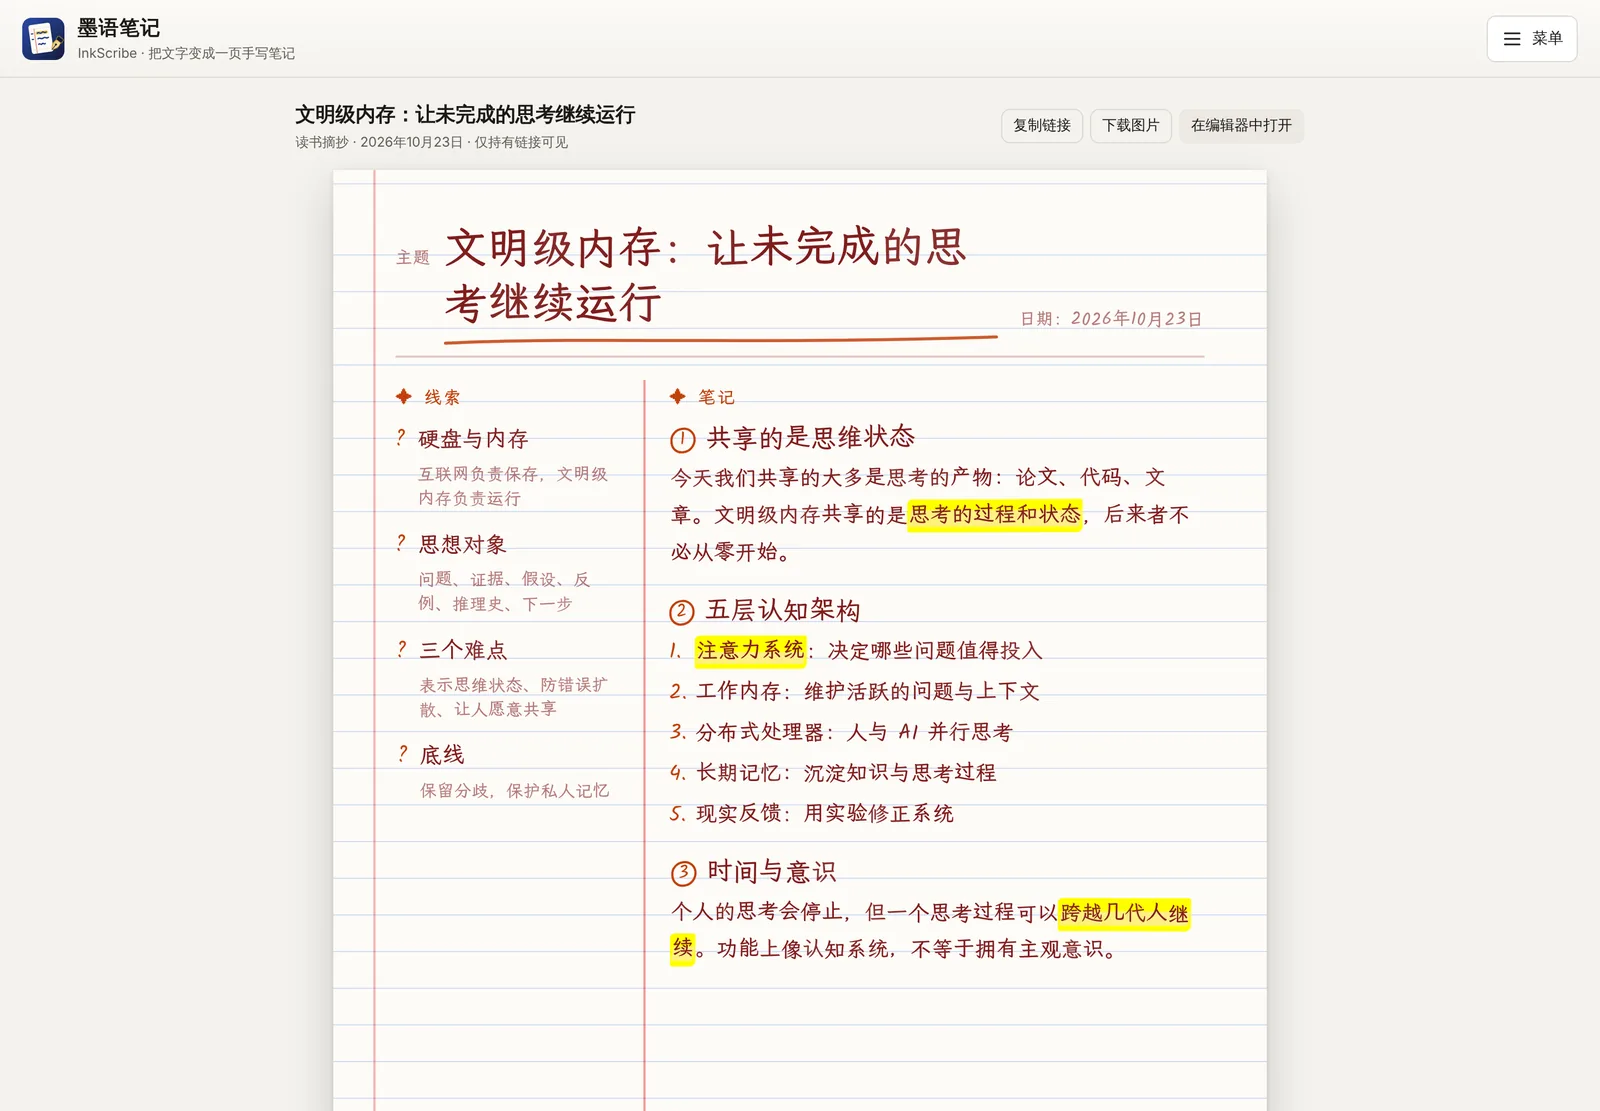
我拿本站前几天的文章《文明级内存》试了一次。原文近四千字,有设想、有表格、有历史案例,也有一节专门讨论它和“文明意识”的区别。整理的工作完全在 agent 自己的上下文里完成:它读完全文,写出一个标题,四条线索(硬盘与内存、思想对象、三个难点、底线),三段正文(共享的是思维状态、五层认知架构、时间与意识),每段挑一个重点词,最后一句总结。然后把这份 JSON 连同外观设置一起 POST 到 /api/v1/notes:
| |
(这里只摘了一部分。)返回的是一个 /n/<id> 链接和一个用于日后删除的 manageToken。打开链接,就是下面这页:
同一份结构只改外观,换成自由手账、复古羊皮纸、龙藏体,又是另一种样子:
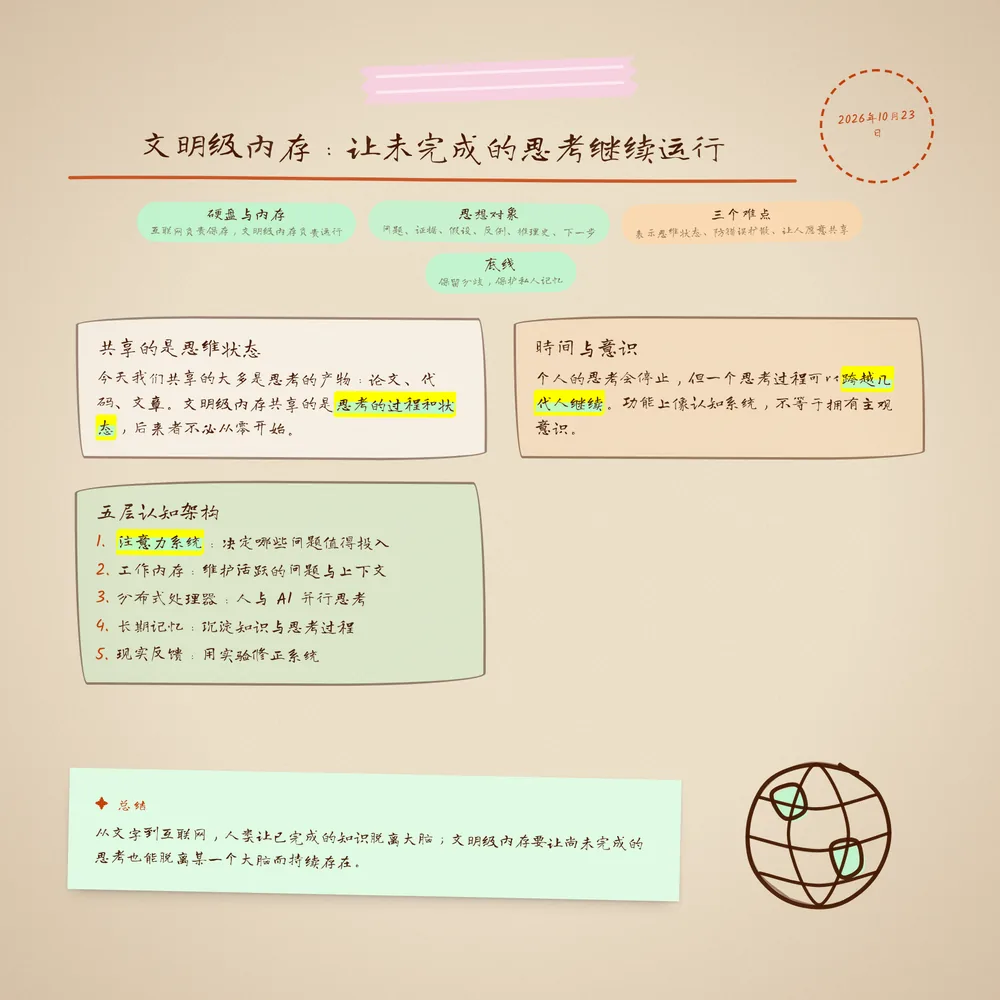
这次体验里,有几处让我觉得分工是对的。
发布接口不收原文。 请求里多带一个 text 字段,校验直接返回 422 UNKNOWN_FIELD。服务端只保存整理后的结构,不调用任何模型,也不重新总结、截断或补写。整理归 agent,排版归工具,谁对哪部分负责,边界很清楚。
错误是可以照着改的。 我故意把第一段的重点词写成“共享思维状态”——正文里其实是“思考的过程和状态”。预检接口 /api/v1/notes/validate 返回的错误是 HIGHLIGHT_NOT_FOUND,路径精确到 note.sections[0].highlights[0]。这对 agent 很友好:它不需要理解一句人话,按路径改掉那一项再提交就行。更重要的是,不合规的数据不会被“宽容地”删掉一部分再发布,你拿到的链接上的内容,就是你提交的内容。
链接默认不公开。 免密钥发布的作品只能是 unlisted:持有链接的人能看,页面带 noindex,不进入图库;按 IP 限流,每天有上限。打开链接的人可以下载图片,也可以点“在编辑器中打开”,接着换纸、加贴纸。
也有不完美的地方。龙藏体好看,但字形随性,放在小字号的线索说明里辨认起来有些吃力;自由手账版式的日期印章装不下“2026年10月23日”这样的长日期,只能折成两行。这类笔记更适合用工整的霞鹜文楷,或者把日期写短一点。
还有一个更根本的提醒:一页笔记只是重构的结果,重构本身才是学习发生的地方。让 agent 替你整理,得到的是一页漂亮的纸,但“哪些是主干”的判断是它做的,不是你做的。写作之所以有用,部分原因正在于它逼着人把模糊的理解落到纸面上。所以我更喜欢的用法是:先自己试着写出线索和总结,再让 AI 整理一版,对照两者的差别;或者反过来,拿到 agent 的笔记后盖住右栏,只看线索,试着把内容讲一遍。
隐私与实现
浏览器从不直接调用模型,也不接触任何凭据。网页里选择 AI 整理时,原文会发送给服务端用于本次整理,但不会写入数据库;日志只记录长度、耗时、错误码这类元数据。上传的文件只在浏览器里解析,文件本身不会离开你的设备。模型的输出在显示之前会被规范化:只保留约定的字段,清理 HTML 和控制字符,重点词必须逐字出现在正文中。
实现上,前端是 Vite + React + TypeScript,排版、手写渲染和图片导出都在浏览器里完成;服务端是一个 Cloudflare Worker,同时托管静态资源和 API,AI 整理通过 Workers AI 调用,模型 ID 与参数全部写在配置里;发布的笔记存在 D1。界面支持中文和英文,以及浅色、深色、跟随系统三种外观。站内的使用说明页给出了网页操作步骤、agent 接入指南和可以直接复制的 JSON 与 curl 示例。
它适合谁
如果你经常读完一篇长文、听完一场讲座、开完一个会,想留下一页能复习、能分享的东西,墨语笔记大概会有用。如果你已经习惯在对话里让 AI 帮你总结,可以试着让它多走一步,把总结交给墨语笔记排成一页纸。它不适合需要多页、长期维护、互相链接的笔记体系——那是笔记软件的事;它只负责“一页”。
第一次打开时,画布上已经有一页示例笔记。最快的上手方式是在“样式”里换几种版式和纸张,看同一份内容怎样变成不同的样子;然后点“撰写”,粘贴一段你这周读过的东西,看看这页纸会怎样重构它。和屿志一样,它也是我放在 Orangely 上的一个小实验。